Нейросеть на своём компьютере: Ollama, LM Studio и какую модель выбрать
Как запустить нейросеть на своём компьютере без интернета и подписок: Ollama, LM Studio и Open WebUI, какие модели в 2026 году лучше всего понимают русский, сколько нужно видеопамяти и калькулятор «какая модель пойдёт на моём ПК». Плюс доступ к своей нейросети с телефона через домашнюю сеть.
Нейросеть, похожая на ChatGPT, может работать прямо на вашем компьютере: без интернета, без подписки, без VPN и без отправки ваших текстов на чужие серверы. Ещё пару лет назад это было игрушкой для энтузиастов. В 2026 году открытые модели вроде Qwen 3.5, Gemma 4 и gpt-oss от OpenAI на обычной игровой видеокарте отвечают на уровне облачных сервисов недавнего прошлого — и нормально говорят по-русски.
Ниже — чем запускать, какую модель выбрать под своё железо и как сделать из домашнего компьютера или сервера собственный «ChatGPT» для всей семьи. Сначала калькулятор: выберите видеокарту, память и задачу — и он покажет, какие модели у вас пойдут и какая лучше всего.
| Модель | Размер | Русский | Подходит для | На вашем ПК |
|---|---|---|---|---|
Qwen 3.5 0.8BКрошечная: для слабых ноутбуков и простых вопросовqwen3.5:0.8b |
1 ГБ | слабо | общение и тексты | — |
Qwen 3.5 2BПонимает картинки, для простых задачqwen3.5:2b |
2,7 ГБ | хорошо | общение и тексты, понимание картинок | — |
Qwen 3.5 4BЛучшее, что влезает в 4–6 ГБqwen3.5:4b |
3,4 ГБ | хорошо | общение и тексты, понимание картинок, сложные задачи | — |
Qwen 3.5 9BГлавный выбор для видеокарты на 8 ГБqwen3.5:9b |
6,6 ГБ | отлично | общение и тексты, понимание картинок, сложные задачи, программирование | — |
Qwen 3.5 27BУровень облачных моделей прошлого поколенияqwen3.5:27b |
17 ГБ | отлично | общение и тексты, понимание картинок, сложные задачи, программирование | — |
Qwen 3.5 35BДля 24–32 ГБ видеопамятиqwen3.5:35b |
24 ГБ | отлично | общение и тексты, понимание картинок, сложные задачи, программирование | — |
Gemma 4 12BGoogle: сильная в текстах и на русскомgemma4:12b |
7,6 ГБ | отлично | общение и тексты, понимание картинок, сложные задачи | — |
Gemma 4 26BСмесь экспертов — быстрее, чем кажется по размеруgemma4:26b |
19 ГБ | отлично | общение и тексты, понимание картинок, сложные задачи, программирование | — |
Gemma 4 31BСамая сильная Gemma для одной видеокартыgemma4:31b |
20 ГБ | отлично | общение и тексты, понимание картинок, сложные задачи, программирование | — |
gpt-oss 20BОткрытая модель OpenAI, хорошо рассуждаетgpt-oss:20b |
14 ГБ | хорошо | общение и тексты, сложные задачи, программирование | — |
DeepSeek-R1 8BДумает перед ответом — для задач и логикиdeepseek-r1:8b |
5,2 ГБ | хорошо | сложные задачи | — |
DeepSeek-R1 14BРассуждения посерьёзнееdeepseek-r1:14b |
9 ГБ | хорошо | сложные задачи, программирование | — |
Qwen2.5-Coder 7BАвтодополнение кода на скромном железеqwen2.5-coder:7b |
4,7 ГБ | хорошо | программирование | — |
Qwen2.5-Coder 14BКод на видеокарте 12 ГБqwen2.5-coder:14b |
9 ГБ | хорошо | программирование | — |
Qwen3-Coder 30BЛучший открытый помощник для кода на одной видеокартеqwen3-coder:30b |
19 ГБ | хорошо | программирование | — |
Mistral Nemo 12BХорошо пишет тексты, большой контекстmistral-nemo |
7,1 ГБ | хорошо | общение и тексты | — |
Phi-4 14BMicrosoft: сильна в математике, русский слабееphi4 |
9,1 ГБ | слабо | общение и тексты, сложные задачи | — |
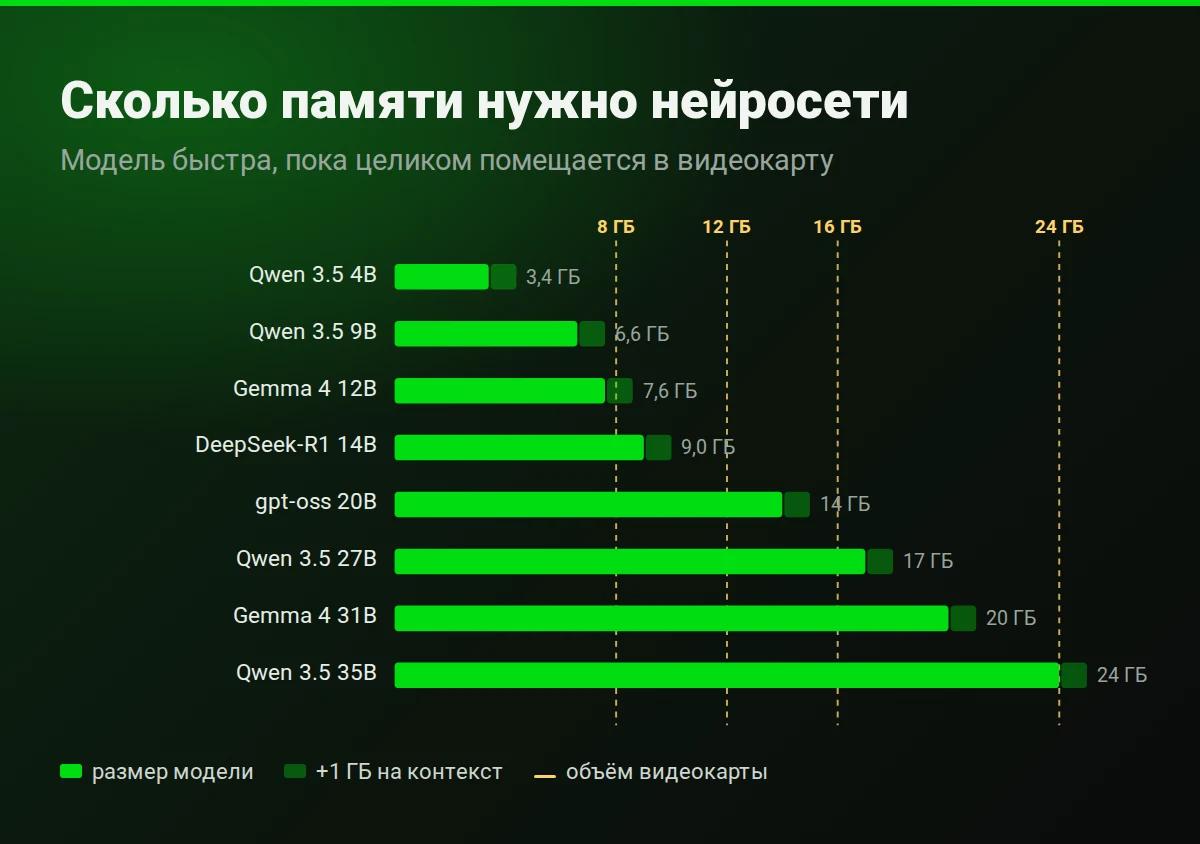
Размеры — для версий из библиотеки Ollama со сжатием до 4 бит. Сверху модели нужен примерно 1 ГБ на «память разговора» — больше, если давать ей длинные документы. Данные на 27.09.2026.
Зачем это нужно
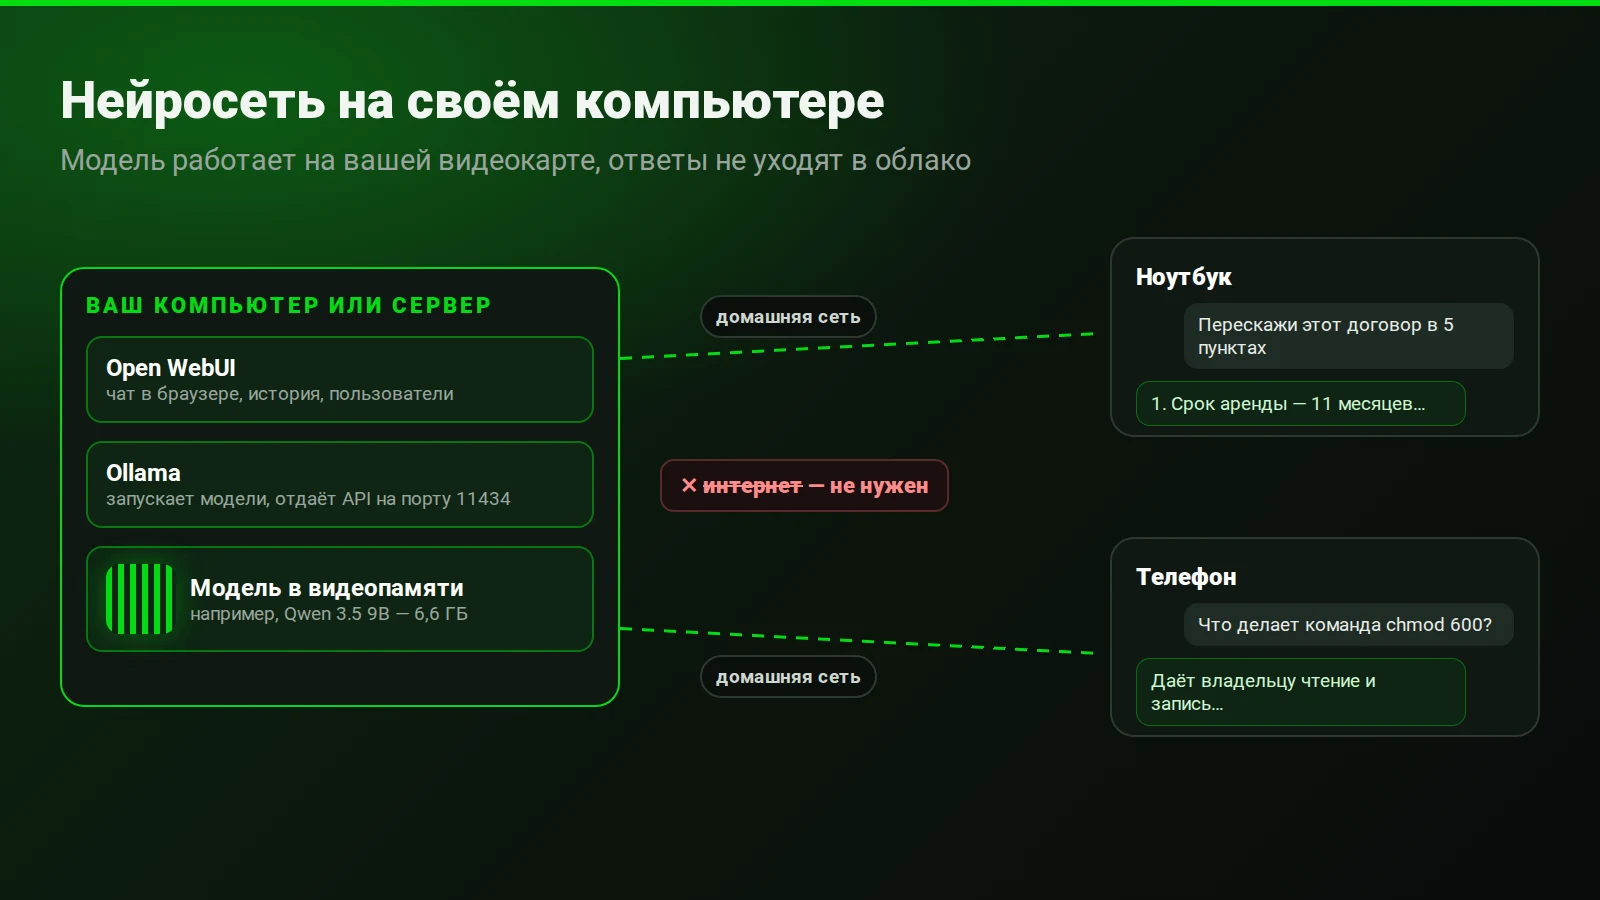
Приватность. Вопросы, документы, код, переписка — всё остаётся у вас. Можно дать нейросети на разбор договор, медицинские анализы или рабочие файлы, не думая, куда они уйдут.
Нет ограничений и подписок. Ни лимитов сообщений, ни оплаты иностранной картой, ни блокировок по региону. Установили один раз — пользуетесь сколько угодно.
Работает без интернета. В дороге, на даче, при отключениях — модель всё равно отвечает.
Для автоматизации. Локальная модель — это просто программа с API. Её можно подключить к своим скриптам, умному дому, заметкам, редактору кода.
Чего ждать не стоит. Модель, которая влезает в видеокарту на 8 ГБ, не заменит самые мощные облачные нейросети в сложных задачах. Но для писем, пересказа текста, перевода, объяснения кода, мозгового штурма и ответов на вопросы её хватает с запасом.
Чем запускать: Ollama, LM Studio или Open WebUI
| Программа | Что это | Кому подходит | Системы |
|---|---|---|---|
| Ollama | Движок для моделей с простым окном чата | Всем: самый простой старт и основа для остального | Windows, macOS, Linux |
| LM Studio | Приложение «всё в одном» с каталогом моделей | Тем, кто хочет всё мышкой, без терминала | Windows, macOS, Linux |
| Open WebUI | Веб-интерфейс как у ChatGPT поверх Ollama | Для домашнего сервера и нескольких пользователей | Любая, через Docker |
Ollama — главный инструмент. Ставится за минуту, модели скачиваются одной командой ollama run имя-модели. С 2025 года у Ollama есть и приложение с окном чата для Windows и macOS: туда можно перетаскивать PDF и картинки. А ещё Ollama работает как служба с API — к ней подключаются все остальные программы.
LM Studio — удобная программа с графическим интерфейсом: встроенный поиск моделей по каталогу Hugging Face, подсказки, влезет ли модель в вашу видеокарту, настройки на ползунках. Хороший выбор, если терминал не хочется открывать совсем.
Open WebUI — то, что превращает Ollama в полноценный «свой ChatGPT»: история чатов, несколько пользователей, загрузка документов, поиск по ним, распознавание речи. Запускается в Docker на компьютере или домашнем сервере и открывается в браузере с любого устройства.
Моя рекомендация: Ollama как основа, а для удобного чата — либо её собственное приложение, либо Open WebUI, если нейросеть будет жить на домашнем сервере.
Какую модель выбрать
Модели отличаются размером — числом параметров в миллиардах (B). Чем больше, тем умнее, но тем больше памяти нужно. Все модели ниже сжаты до 4 бит на параметр — так они занимают в 3–4 раза меньше места почти без потери качества.
Для русского языка лучше всего подходят семейства Qwen 3.5 от Alibaba и Gemma 4 от Google — они пишут грамотно и понимают контекст. gpt-oss от OpenAI сильна в рассуждениях, но по-русски пишет чуть суше. Модели Llama и Phi заметно слабее в русском.
Короткая шпаргалка по видеокарте:
| Видеопамять | Что брать | Команда |
|---|---|---|
| Нет видеокарты, 16 ГБ ОЗУ | Qwen 3.5 4B — медленно, но работает | ollama run qwen3.5:4b |
| 6 ГБ | Qwen 3.5 4B | ollama run qwen3.5:4b |
| 8 ГБ (RTX 4060, 5060) | Qwen 3.5 9B | ollama run qwen3.5:9b |
| 12 ГБ | Gemma 4 12B | ollama run gemma4:12b |
| 16 ГБ | gpt-oss 20B | ollama run gpt-oss:20b |
| 24 ГБ | Gemma 4 31B или Qwen 3.5 27B | ollama run gemma4:31b |
Для программирования берите специализированные модели: Qwen2.5-Coder на 7 или 14 миллиардов параметров для скромного железа и Qwen3-Coder 30B, если есть 24 ГБ видеопамяти.
Для сложных задач — модели, которые «думают» перед ответом: DeepSeek-R1, gpt-oss и новые Qwen. Они сначала рассуждают, потом отвечают — дольше, но точнее в математике и логике.
Понимание картинок есть у Qwen 3.5 и Gemma 4: можно отправить скриншот, фото документа или график и спросить, что на нём.
Есть и российские открытые модели — например, облегчённые версии YandexGPT и T-Pro от Т-Банка. Они выложены на Hugging Face, и их можно запустить через LM Studio. Но по общему уровню Qwen и Gemma сейчас сильнее.
Установка и запуск
Всё сводится к трём шагам: поставить Ollama, скачать модель, начать разговор. Конструктор ниже соберёт команды под вашу систему — включая Open WebUI и доступ с телефона.
Конструктор команд: Ollama и Open WebUI
Установка, управление моделями, чат в браузере и доступ с других устройств домашней сети.
После ollama run откроется чат прямо в терминале. Выйти — командой /bye. В следующий раз модель запустится сразу, без скачивания.
Сколько это стоит по железу
Видеокарта — главное. Модель должна целиком поместиться в видеопамять, тогда ответ идёт быстро, со скоростью чтения и выше. Если не влезает, часть модели уходит в оперативную память, и скорость падает в несколько раз.
- NVIDIA — лучший вариант: всё работает из коробки.
- AMD Radeon — работает через ROCm или Vulkan, в Linux обычно проще, чем в Windows.
- Intel Arc и встроенная графика — через Vulkan, медленнее.
- Mac на Apple Silicon — отлично: видеокарта и процессор используют общую память, так что Mac с 32 ГБ тянет модели, которым на ПК нужна дорогая видеокарта.
Без видеокарты модели работают на процессоре. Маленькая модель на 4 миллиарда параметров будет отвечать по слову в секунду-две — для коротких вопросов терпимо.
Диск. Модели весят от 1 до 25 ГБ каждая. Держите их на SSD: с жёсткого диска загрузка займёт минуты.
Электричество. Видеокарта нагружается только во время ответа. В простое модель просто лежит в памяти и почти ничего не потребляет.
Своя нейросеть на домашнем сервере
Если у вас есть домашний сервер или просто компьютер, который часто включён, нейросеть можно поставить туда один раз — и пользоваться с телефона, ноутбука и планшета.
Схема простая: на сервере работает Ollama, рядом в Docker — Open WebUI. Открываете в браузере телефона http://адрес-сервера:3000, входите в свою учётную запись — и у вас свой ChatGPT, который никуда не отправляет ваши данные. У каждого члена семьи может быть своя учётная запись и своя история чатов.
Для этого нужна видеокарта в сервере. В мини-ПК без дискретной графики хватит маленьких моделей, а полноценно всё работает на компьютере с игровой видеокартой. Важно: не открывайте Ollama в интернет — у неё нет паролей. Для доступа из-за пределов дома используйте VPN. Как защитить сам сервер, рассказано в статье про защиту Ubuntu Server.
Частые вопросы
Можно ли запустить нейросеть без видеокарты?
Да, на процессоре. Маленькие модели на 1–4 миллиарда параметров работают на любом компьютере с 8–16 ГБ оперативной памяти, но отвечают медленно — примерно по слову в секунду. Для постоянной работы видеокарта очень желательна.
Какая локальная нейросеть лучше всего понимает русский?
На 2026 год — Qwen 3.5 и Gemma 4. Обе пишут грамотно и понимают контекст. Если видеопамяти 8 ГБ — берите Qwen 3.5 9B, если 12 ГБ — Gemma 4 12B.
Это бесплатно?
Да. Ollama, LM Studio и Open WebUI бесплатны, модели тоже. Большинство моделей выпущены под свободными лицензиями, которые разрешают и коммерческое использование — но у каждой лицензия своя, для работы стоит проверить.
Нужен ли интернет?
Только чтобы один раз скачать программу и модель. Дальше всё работает полностью офлайн.
Чем Ollama отличается от LM Studio?
Ollama — движок, который удобно ставить на сервер и подключать к другим программам, с простым окном чата. LM Studio — программа с богатым графическим интерфейсом и каталогом моделей, удобная на личном компьютере. Можно пользоваться обеими.
Может ли локальная нейросеть генерировать картинки?
Модели из этой статьи работают с текстом и понимают картинки, но не рисуют. Для генерации изображений нужны другие программы — например, ComfyUI с моделями вроде Stable Diffusion или FLUX, и видеокарта от 8 ГБ.
Модель отвечает медленно. Что делать?
Проверьте командой ollama ps, где она работает. Если там не 100% GPU, модель не поместилась в видеопамять — возьмите версию поменьше. Ещё помогает закрыть игры и браузер с тяжёлыми вкладками: они тоже занимают видеопамять.
Что дальше
Начните с малого: поставьте Ollama, скачайте модель, которую посоветовал калькулятор, и попросите её пересказать длинную статью или объяснить непонятную команду Linux. Если понравится — переносите на домашний сервер и подключайте Open WebUI.
Если для нейросети понадобится мощная видеокарта, пригодится разбор игр на Linux — там подробно про драйверы NVIDIA и AMD. А следить за температурой видеокарты под нагрузкой поможет статья про мониторинг температуры.
Если статья пригодилась — отметьте, это помогает выбирать темы
Статья помогла?
Комментарии
Пока никто не написал. Будьте первым — вопрос или свой опыт одинаково полезны.